딥시크, KV 캐시 4분의 1로 줄인 'V4.1 플래시' 공개...층 간 캐시 공유·FP4 저장으로 장기 AI 에이전트 비용 절감 겨냥
딥시크가 KV 캐시 저장량을 이전 모델의 4분의 1로 줄인 AI 모델을 공개했다.
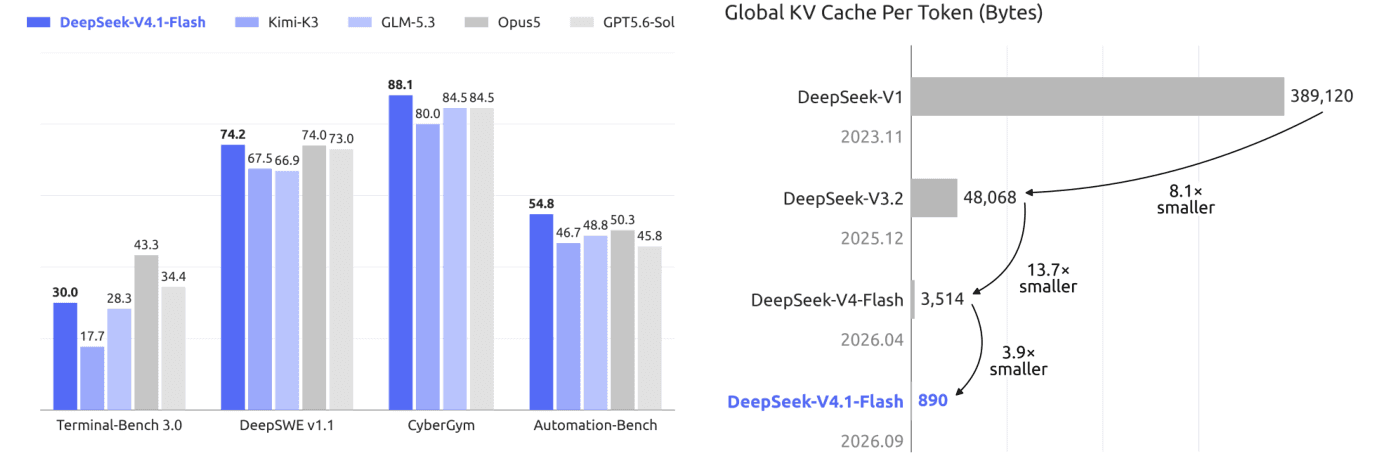
[한국정보기술신문] 중국 인공지능(AI) 기업 딥시크(DeepSeek)가 대규모 언어모델 'DeepSeek-V4.1-Flash'와 기술보고서를 공개했다. 이 모델의 핵심 목표는 AI가 긴 대화를 처리할 때 쌓이는 임시 기억 공간, 즉 'KV 캐시'를 최대한 줄이는 것이다. 기술보고서에 따르면 같은 문장 길이 기준으로 실행 중 필요한 KV 캐시는 전작 V4-Flash의 약 4분의 1, 나중에 다시 쓰기 위해 보관하는 캐시는 약 8분의 1 수준이다.
왜 KV 캐시가 문제인가
KV 캐시는 AI 모델이 앞서 읽은 내용을 다시 계산하지 않도록 저장해 두는 중간 결과물이다. 문서가 길어질수록 이 저장량도 함께 늘어난다. 최근에는 여러 도구를 오가며 오랜 시간 작업하는 'AI 에이전트'가 확산되면서 문맥 길이가 크게 늘었다. 보고서는 이로 인해 캐시가 고대역폭 메모리(HBM)와 SSD 저장 공간을 많이 차지하고, 캐시를 옮기는 데 필요한 통신 대역폭 부담도 커졌다고 설명했다. 이는 서비스 처리량을 떨어뜨리고 운영 비용을 높이는 원인이 된다.
V4.1 플래시는 전체 매개변수가 5520억 개인 전문가 혼합(MoE) 모델이다. MoE는 384개의 소규모 '전문가' 신경망 가운데 입력마다 6개만 골라 쓰는 방식이다. 이미지 입력을 기본 지원하며, 최대 100만 토큰 길이의 문맥을 처리할 수 있다. 입력을 읽는 단계(프리필)에서는 토큰당 80억 개, 답을 생성하는 단계(디코드)에서는 160억 개의 매개변수만 활성화된다.
앞 20층이 기억 만들고, 뒤 20층은 읽기만
첫 번째 핵심 기술은 '인과 인코더-디코더(CED)' 구조다. 모델의 40개 층을 절반으로 나눠, 앞쪽 20개 층(인코더)이 문맥 정보를 만들고 뒤쪽 20개 층(디코더)은 이를 공유해 읽는다. 마이크로소프트 연구진이 제안한 YOCO 구조에서 착안한 방식이다. 긴 입력의 대부분은 앞쪽 20개 층만 통과하면 되므로, 입력 처리 계산량이 이론상 절반 가까이 줄어든다.
다만 이 구조에는 대가도 있다. 디코더의 일부 국소 정보를 복원할 때 전체 과거를 되짚지 않고 최근 일부 구간만 다시 계산하기 때문에, 복원된 값은 근사치가 된다. 딥시크는 이 오차를 품질 평가와 후속 학습으로 관리한다고 밝혔다.
여러 층이 캐시 한 벌을 나눠 쓴다
두 번째 기술은 새 주의 집중 방식인 'CSA2'다. 주의 집중(어텐션)은 AI가 과거 문맥 가운데 어디를 참고할지 정하는 계산이다. 기존에는 층마다 자기 캐시를 따로 저장했지만, CSA2는 여러 층이 같은 캐시를 함께 쓰도록 했다.
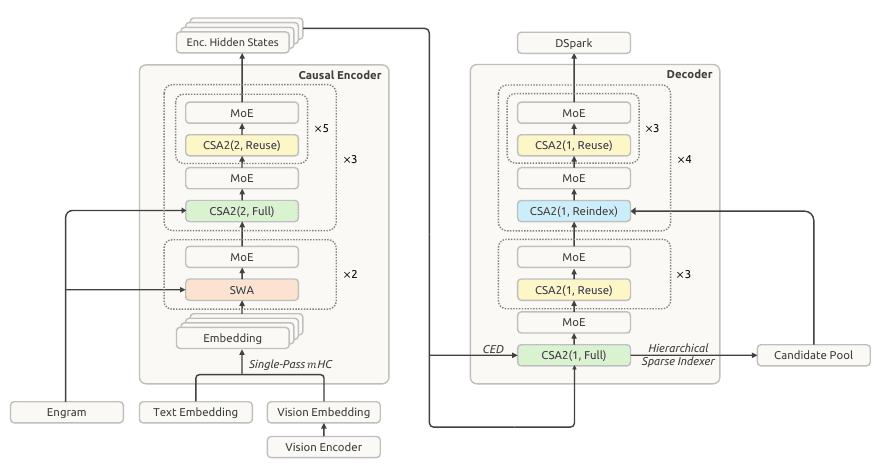
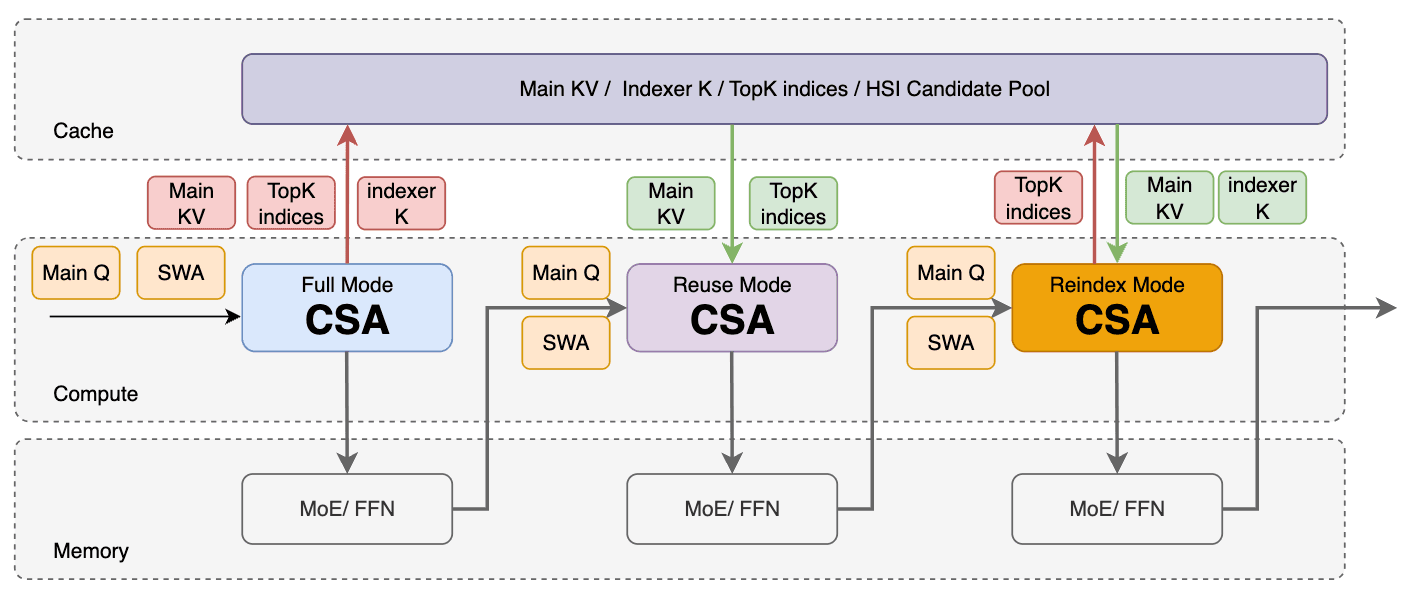
각 층은 세 가지 방식 중 하나로 작동한다. '풀' 층은 캐시와 참고 위치 목록을 새로 만든다. '리인덱스' 층은 캐시는 빌려 쓰되 참고 위치만 다시 고른다. '리유즈' 층은 캐시와 위치 목록을 모두 빌리고, 무엇을 찾을지 묻는 질의만 새로 계산한다. 그 결과 전체 신경망에는 인코더용 캐시 3벌과 디코더용 1벌만 남는다. 인코더에서는 인접한 두 위치를 하나로 합쳐 저장량을 더 줄였다.
디코더에는 '계층형 희소 인덱서(HSI)'도 적용됐다. 첫 층이 전체 문맥에서 점수가 높은 구간 2048개(위치 1만6384개)를 먼저 추려두면, 이후 층은 그 안에서만 512개 위치를 고른다. 문맥이 아무리 길어져도 뒤쪽 층의 검색 비용은 일정하게 유지된다.
세 방향 압축을 한 모델에 모아
딥시크는 그간 캐시 압축을 단계적으로 발전시켜 왔다. V3 계열의 MLA 기술은 여러 주의 집중 헤드가 작은 공통 벡터 하나를 나눠 쓰게 해 캐시 한 칸의 크기를 줄였다. V3.2에서는 문맥 전체가 아닌 일부만 골라 계산하는 희소 주의 집중을 도입했다. V4에서는 여러 토큰을 하나로 묶어 저장하는 방식으로 문장 길이 방향의 압축을 더했다. V4.1 플래시는 이 흐름의 연장선에 있는 모델이다.
자트봇은 CSA2가 여기에 층 방향 압축까지 더해 칸 크기, 문장 길이, 층 수라는 세 방향의 절감 효과를 곱으로 결합했다고 분석했다. 기존에도 여러 층이 캐시를 공유하거나 참고 위치 목록을 재사용하는 연구는 있었다. 그러나 저장 공간만 줄이고 계산은 줄이지 못하거나, 반대로 계산만 줄이는 등 한쪽에 치우친 경우가 많았다는 설명이다.
이미지와 텍스트를 함께 학습하는 과정에서 생기는 불균형도 손봤다. 이미지 토큰과 텍스트 토큰은 선호하는 전문가 신경망이 달라, 둘을 한꺼번에 관리하면 특정 전문가에게 일이 몰리는 현상이 가려질 수 있다. 딥시크는 텍스트와 이미지에 각각 별도의 보정값을 두어, 두 종류의 입력 안에서 전문가 사용량이 고르게 분산되도록 했다.
저장 정밀도도 절반으로
세 번째는 숫자 저장 정밀도 조정이다. V4.1 플래시는 주 KV 캐시를 4비트 부동소수점(FP4) 형식으로 저장한다. 업계 공개 표준인 MXFP4 형식을 채택해 여러 하드웨어에서 쓸 수 있도록 했다. 보고서는 이 방식으로 전작의 8비트(FP8) 캐시 대비 메모리와 SSD 저장 공간이 절반 가까이 줄었다고 밝혔다. 정밀도 저하에 민감한 최근 128개 토큰 구간의 캐시는 8비트를 유지했다.
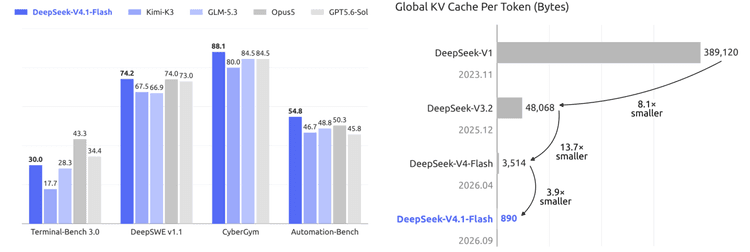
자트봇의 계산에 따르면 이런 기법을 모두 합친 결과, 토큰 하나당 전역 캐시 저장량은 약 890바이트다. 같은 방식으로 계산한 V4-Flash의 약 3514바이트와 비교하면 4분의 1 수준이다.
이 밖에 자주 쓰이는 짧은 어구 패턴을 별도 표에 저장해 두는 '엔그램(Engram)' 모듈에 1960억 개의 매개변수가 배정됐다. 다음에 나올 토큰 여러 개를 미리 추측해 생성 속도를 높이는 'DSpark' 기술도 탑재됐다. 이미지는 32층 규모의 시각 인코더를 거쳐 한 장당 최대 1024개 토큰으로 변환된다.
보고서는 V4.1 플래시가 V4-Flash보다 규모는 크지만 전반적인 성능은 더 우수하다고 밝혔다. 자트봇 운영자는 직접 사용해 본 결과 초당 약 420토큰의 생성 속도를 경험했다고 전했다. 다만 이 수치는 개인 사용 경험으로, 공인된 벤치마크 결과는 아니다.
한계도 지적된다. 자트봇은 리유즈 층이 앞 층의 캐시와 위치 목록을 그대로 쓰기 때문에, 앞 층이 중요한 정보를 놓치면 뒤 층에서 이를 바로잡을 수 없다고 분석했다. 또 HSI를 어떤 방식으로 학습시켰는지는 보고서에 공개되지 않아, 구체적인 학습 방법은 추정에 기댈 수밖에 없다고 설명했다. 이번 분석은 딥시크의 자체 보고서와 외부 개인 블로그의 해설에 근거한 것으로, 실제 서비스 환경에서의 비용 절감 폭과 품질은 제3자의 독립적인 검증을 거쳐야 확인될 전망이다.
자트봇 운영자는 처음에는 이 모델을 단순한 후속 학습 개선판으로 여겼으나, 기술보고서를 확인한 뒤 사실상 차세대(V5)급 모델로 봐야 한다고 평가했다. 장기 작업형 AI 에이전트 시장이 커지는 가운데, 메모리 사용량 절감이 AI 서비스 비용 경쟁의 새 기준이 될지 주목된다.
한국정보기술신문 인공지능분과 이준 기자 news@kitpa.org